Huffman Coding
Huffman kodlash nima?
Huffman kodlash (Huffman Coding) — bu ma'lumotlarni hech qanday yo'qotishlarsiz (lossless compression) uning hajmini qisqartirish uchun mo'ljallangan siqish usulidir. U birinchi marta 1952-yilda David Huffman tomonidan ishlab chiqilgan.
Huffman kodlash asosan belgilar turlicha takrorlanish chastotasiga ega bo'lgan ma'lumotlarni siqishda juda yuqori samara beradi.
Huffman kodlash qanday ishlaydi?
Faraz qilaylik, tarmoq orqali quyidagi satrni jo'natishimiz kerak:
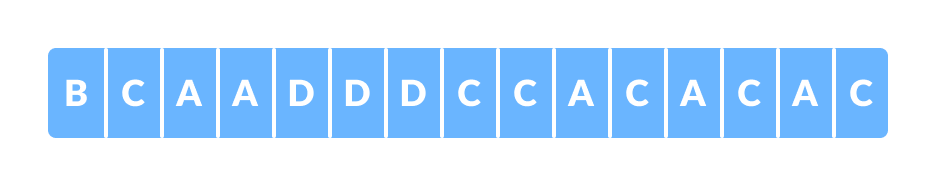
Boshlang'ich satr: BCAADDDCCACACAC
Standart ASCII kodlashda har bir belgi 8 bit (1 bayt) joy egallaydi. Yuqoridagi satrda jami 15 ta belgi mavjud. Demak, ushbu satrni oddiy holatda saqlash yoki yuborish uchun 8 * 15 = 120 bit talab etiladi.
Huffman kodlash texnikasidan foydalanib, biz ushbu ma'lumotni ancha kichik o'lchamdagi bitlar ketma-ketligiga siqishimiz mumkin.
Huffman algoritmi dastlab belgilarning uchrash chastotalari (frequencies) asosida maxsus ikkilik daraxt (Huffman daraxti) quradi, so'ngra har bir belgi uchun o'zgaruvchan uzunlikdagi noyob kod hosil qiladi:
- Ko'p uchraydigan belgilarga qisqa kodlar (masalan, 1 yoki 2 bit);
- Kam uchraydigan belgilarga esa uzunroq kodlar beriladi.
Ma'lumotlar kodlangandan so'ng, ularni asl holiga qaytarish (dekodlash) xuddi shu daraxt orqali amalga oshiriladi.
Prefix Code
Prefiks kodi xususiyati:
Huffman kodlash dekodlash jarayonida hech qanday noaniqlik (ambiguity) yuzaga kelmasligini ta'minlash uchun prefiks kodi tamoyiliga tayanadi. Ya'ni, hech qaysi belgining kodi boshqa biror belgining kodining boshlanish qismi (prefiksi) bo'la olmaydi. Huffman ikkilik daraxtining tuzilishi bu qoidani avtomatik ravishda kafolatlaydi, chunki barcha haqiqiy belgilar faqatgina daraxtning barglarida (leaf nodes) joylashadi.
Huffman kodlash bosqichlari
Huffman kodlash quyidagi bosqichlar asosida amalga oshiriladi:
-
Satrdagi har bir belgining uchrash chastotasini hisoblash:
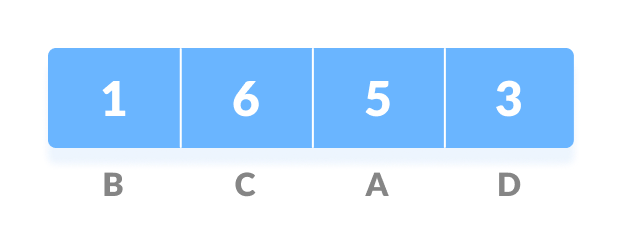
Satrdagi belgilar chastotasi: A: 5, B: 1, C: 6, D: 3
-
Belgilarni chastotalari o'sish tartibida saralab, ularni ustuvorlik navbatiga (priority queue
Q/ min-heap) joylashtirish: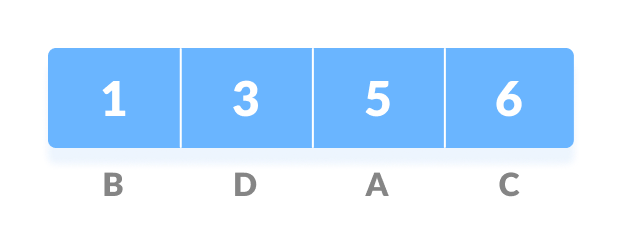
Chastotalar bo'yicha o'sish tartibida saralangan belgilar: B(1), D(3), A(5), C(6)
-
Har bir noyob belgidan alohida barg tugunini (leaf node) hosil qilish.
-
Yangi bo'sh
ztugunini yaratamiz. Ustuvorlik navbatidan eng kichik ikkita chastotali tugunni olib, ularning birinchisinizning chap bolasiga, ikkinchisini esazning o'ng bolasiga biriktiramiz.zning qiymatini ushbu ikki minimal chastotaning yig'indisiga tenglashtiramiz: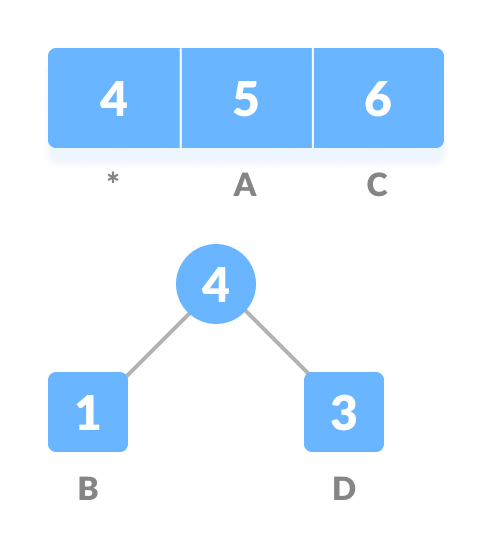
Eng kichik ikkita chastotani birlashtirish: B(1) + D(3) = 4
-
Ushbu ikkita minimal chastotani navbatdan (
Q) o'chirib, ularning yig'indisi bo'lgan yangiztugunini qayta navbatga qo'shamiz (yulduzcha*oraliq ichki tugunni bildiradi). -
Yangi
ztuguni daraxtga qo'shiladi. -
Barcha belgilar bitta daraxtga birlashguniga qadar 3–5-qadamlar takrorlanadi:
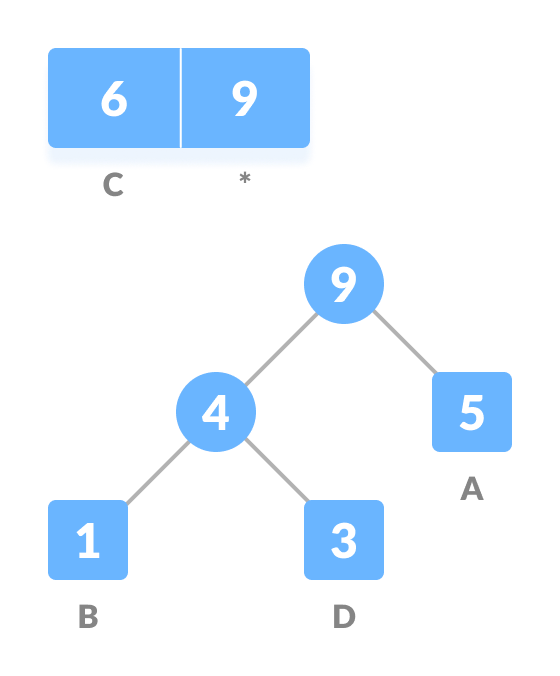
Jarayonni takrorlash: 4 + A(5) = 9
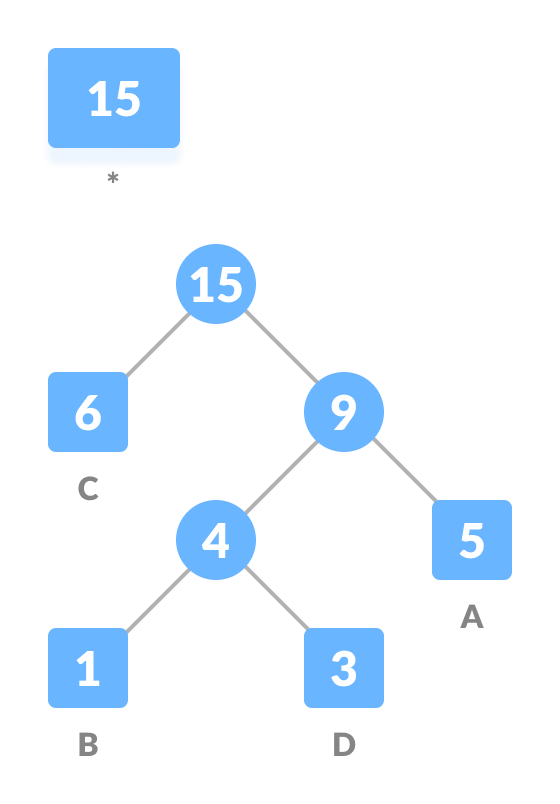
Jarayonni yakunlash: C(6) + 9 = 15 (ildiz tugun shakllandi)
-
Har bir oraliq (ichki) tugunning chap qirrasiga 0, o'ng qirrasiga esa 1 qiymatini yozib chiqamiz:
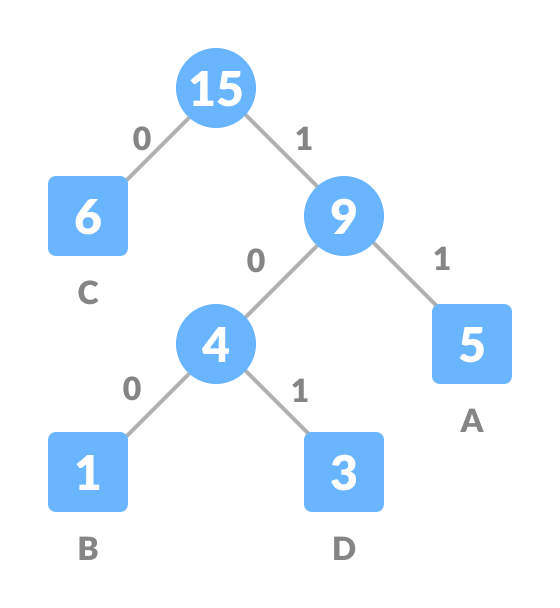
Chap qirraga 0, o'ng qirraga 1 berish orqali prefiks kodlarini hosil qilish
Siqish samaradorligi tahlili
Yuqoridagi satrni tarmoq orqali yuborish uchun siqilgan bitlar bilan birga daraxt strukturasi ma'lumotlarini ham yuborish lozim bo'ladi. Umumiy hajm quyidagi jadvalda ko'rsatilgan:
| Belgi (Character) | Chastotasi (Frequency) | Huffman kodi | Hajmi (bit) |
|---|---|---|---|
| A | 5 | 11 | 5 * 2 = 10 |
| B | 1 | 100 | 1 * 3 = 3 |
| C | 6 | 0 | 6 * 1 = 6 |
| D | 3 | 101 | 3 * 3 = 9 |
| Daraxt ma'lumotlari | 4 * 8 = 32 bit | Chastotalar: 15 bit | Siqilgan matn: 28 bit |
Kodlashsiz dastlabki satr hajmi 120 bit edi. Huffman kodlashdan so'ng umumiy hajm 32 + 15 + 28 = 75 bit ga qisqardi! Bu qariyb 40% hajm tejalganini anglatadi.
Decoding
Dekodlash jarayoni:
Kodni dekodlash (asl matnga qaytarish) uchun qabul qilingan bitlar oqimi bo'ylab daraxtning ildizidan (root) harakatlanamiz:
- Agar bit
0bo'lsa — chap tarmoqqa o'tamiz; - Agar bit
1bo'lsa — o'ng tarmoqqa o'tamiz; - Barg tuguniga yetib kelganda, unga tegishli belgini natijaga qo'shamiz va navbatdagi bit uchun yana ildizga qaytamiz.
Masalan, 101 kodini dekodlash uchun ildizdan quyidagicha harakatlanamiz: 1 (o'ngga) -> 0 (chapga) -> 1 (o'ngga) -> va D bargiga yetib boramiz:
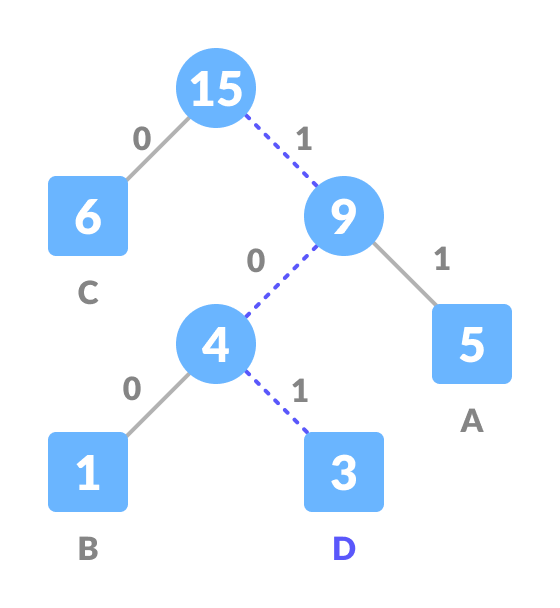
101 kodini dekodlash: natija D belgisi
Huffman kodlash algoritmi psevdokodi
create a priority queue Q consisting of each unique character.
sort them in ascending order of their frequencies.
for all the unique characters:
    create a newNode
    extract minimum value from Q and assign it to leftChild of newNode
    extract minimum value from Q and assign it to rightChild of newNode
    calculate the sum of these two minimum values and assign it to the value of newNode
    insert this newNode into the tree
return rootNode
Dasturiy kod
package main

import (
	"container/heap"
	"fmt"
	"sort"
)

// Daraxt tuguni
type Node struct {
	char  rune
	freq  int
	left  *Node
	right *Node
}

// Min-heap ustuvorlik navbati
type PriorityQueue []*Node

func (pq PriorityQueue) Len() int           { return len(pq) }
func (pq PriorityQueue) Less(i, j int) bool { return pq[i].freq < pq[j].freq }
func (pq PriorityQueue) Swap(i, j int)      { pq[i], pq[j] = pq[j], pq[i] }
func (pq *PriorityQueue) Push(x any)        { *pq = append(*pq, x.(*Node)) }
func (pq *PriorityQueue) Pop() any {
	old := *pq
	n := len(old)
	item := old[n-1]
	*pq = old[0 : n-1]
	return item
}

// Huffman kodlarini daraxt bo'yicha rekursiv generatsiya qilish
func buildHuffmanCodes(node *Node, code string, codes map[rune]string) {
	if node == nil {
		return
	}
	// Barg tuguni (leaf node) bo'lsa, belgiga kodni biriktiramiz
	if node.left == nil && node.right == nil {
		codes[node.char] = code
		return
	}
	buildHuffmanCodes(node.left, code+"0", codes)
	buildHuffmanCodes(node.right, code+"1", codes)
}

func main() {
	str := "BCAADDDCCACACAC"

	// 1-qadam: Belgilar chastotasini hisoblash
	freq := make(map[rune]int)
	for _, ch := range str {
		freq[ch]++
	}

	// 2-qadam: Min-heap ustuvorlik navbatini to'ldirish
	pq := &PriorityQueue{}
	heap.Init(pq)
	for ch, count := range freq {
		heap.Push(pq, &Node{char: ch, freq: count})
	}

	// 3-qadam: Huffman daraxtini qurish
	for pq.Len() > 1 {
		left := heap.Pop(pq).(*Node)
		right := heap.Pop(pq).(*Node)
		parent := &Node{
			freq:  left.freq + right.freq,
			left:  left,
			right: right,
		}
		heap.Push(pq, parent)
	}

	root := heap.Pop(pq).(*Node)
	codes := make(map[rune]string)
	buildHuffmanCodes(root, "", codes)

	// Chastotasi bo'yicha saralab natijani chop etish
	type Pair struct {
		char rune
		freq int
	}
	var sortedFreq []Pair
	for ch, f := range freq {
		sortedFreq = append(sortedFreq, Pair{ch, f})
	}
	sort.Slice(sortedFreq, func(i, j int) bool {
		return sortedFreq[i].freq > sortedFreq[j].freq
	})

	fmt.Println(" Char | Huffman code ")
	fmt.Println("----------------------")
	for _, p := range sortedFreq {
		fmt.Printf(" '%c'  |%12s\n", p.char, codes[p.char])
	}
}
Huffman kodlash algoritmining murakkabligi
- Vaqt murakkabligi (Time Complexity):
O(n log n), bu yerdan— noyob belgilar soni. Ustuvorlik navbatidan (min-heap) minimal elementni chiqarib olishO(log n)vaqt oladi va bu operatsiya2 * (n - 1)marta bajariladi. - Xotira murakkabligi (Space Complexity):
O(n)(daraxt tugunlari va ustuvorlik navbati uchun).
Huffman kodlashning amaliy qo'llanilishi
- Ma'lumotlarni siqish arxivatorlari: GZIP, BZIP2, PKZIP, ZIP va 7-Zip kabi mashhur arxivlash formatlarida asosiy siqish qatlamlaridan biri sifatida ishlatiladi.
- Multimedia formatlari: JPEG tasvirlari va MP3 audio fayllarini siqish jarayonining yakuniy bosqichida qo'llaniladi.
- Matnli aloqa va faks: Matnli ma'lumotlar va faks xabarlarini tezkor uzatish tizimlarida.