INDEX
Indekslar haqida umumiy tushuncha
Ushbu qo'llanmada PostgreSQLda ma'lumotlar qanday saqlanishi, indekslar nima ekanligi va ulardan so'rovlar unumdorligini oshirish uchun qanday foydalanishni o'rganasiz.
PostgreSQL ma'lumotlarni qayerda saqlaydi?
Avvalo, PostgreSQL ma'lumotlar katalogining (data directory) joylashuvini ko'rish uchun SHOW data_directory; buyrug'ini ishlatishingiz mumkin:
SHOW data_directory;
Natija operatsion tizimingizga qarab quyidagicha bo'ladi:
           data_directory
-------------------------------------
 C:/Program Files/PostgreSQL/17/data
 -- yoki Linux/macOSda: /var/lib/postgresql/17/main yoki /usr/local/var/postgres
Ushbu katalog ichida PostgreSQL serverining barcha ma'lumotlar fayllari, konfiguratsiyalari va jurnallari (logs) saqlanadi.
Har bir ma'lumotlar bazasiga o'zining noyob raqami — OID (Object Identifier) beriladi. Masalan, bazalarning OID raqamlarini bilish uchun:
SELECT oid, datname FROM pg_database;
Jadvallar ham xuddi shunday OID raqamiga ega bo'ladi:
SELECT
  c.oid,
  c.relname
FROM
  pg_class c
  JOIN pg_namespace n ON n.oid = c.relnamespace
WHERE
  c.relkind = 'r'
  AND n.nspname NOT IN ('pg_catalog', 'information_schema');
PostgreSQL ma'lumotlarni qanday saqlaydi?
PostgreSQL jadvallarni diskda heap file (to'plam fayli) saqlash modeli orqali saqlaydi. Har bir jadval o'zining heap fayliga ega bo'ladi.
Har bir heap fayl bloklardan (yoki sahifalardan - pages) tashkil topgan. Sukut bo'yicha har bir blok hajmi 8 KB ni tashkil etadi. Har bir blok ichida esa jadvalning bir nechta qatorlari (tuples) joylashadi.
To'liq jadvalni skanerlash (Full Table Scan / Seq Scan)
Jadvaldan ma'lumot izlaganingizda, agar hech qanday indeks bo'lmasa, PostgreSQL heap fayldagi har bir blokni ketma-ket xotiraga yuklab, shartga mos qatorlarni bittalab tekshirib chiqishga majbur bo'ladi.
Bu jarayon ketma-ket skanerlash (Sequential Scan yoki Seq Scan) deb ataladi. Millionlab qatorlarga ega jadvallarda butun faylni o'qib chiqish diskka katta yuklama beradi va so'rovning bajarilishini juda sekinlashtiradi.
Indeks nima?
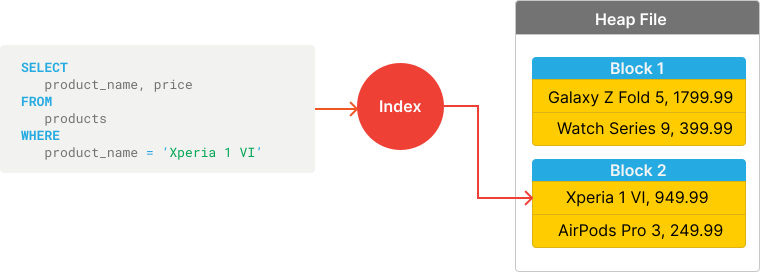
Indeks (Index) — bu jadvaldagi kerakli qatorlarni to'liq skanerlamasdan, darhol va chaqqon topish imkonini beruvchi alohida yordamchi ma'lumotlar tuzilmasidir.
Indeksni kitobning eng oxiridagi mundarija yoki kalit so'zlar ko'rsatkichiga qiyoslash mumkin: butun kitobni boshidan oxirigacha varaqlab o'tirmasdan, ko'rsatkichdan kerakli mavzu qaysi sahifada ekanini bilib, to'g'ridan-to'g'ri o'sha sahifani ochasiz.
Indeks qanday tuziladi?
- 1-qadam: Tez qidirish talab etiladigan ustun (masalan,
product_name) tanlanadi:
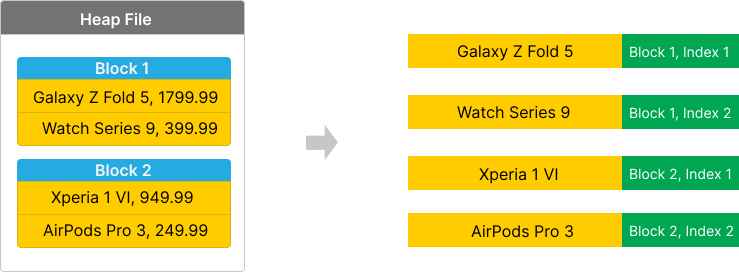
- 2-qadam: Tanlangan ustun qiymatlari va ularning tegishli blokdagi o'rni (manzili) ajratib olinadi:
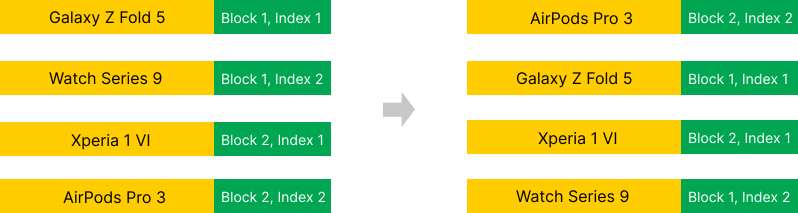
- 3-qadam: Ushbu qiymatlar saralanadi (masalan, matnlar alifbo bo'yicha, sonlar o'sish tartibida):
- 4-qadam: Ma'lumotlar muvozanatlashgan daraxt — B-Tree (Balanced Tree) tuzilmasiga joylashtiriladi:
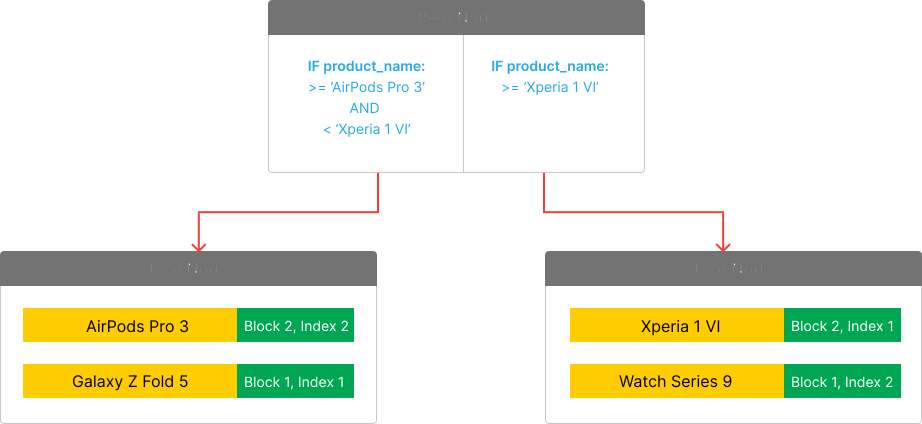
- 5-qadam: Qidiruv paytida PostgreSQL ildiz tugunidan (root) boshlab bir nechta tezkor sakrashlar orqali barg tugundagi (leaf node) aniq manzilni topadi va to'g'ridan-to'g'ri o'sha blokdagi qatorni o'qiydi.
CREATE INDEX buyrug'i
PostgreSQLda indeks yaratish uchun CREATE INDEX buyrug'i ishlatiladi:
CREATE INDEX index_name ON table_name (column_name);
Agar indeks nomi ko'rsatilmasa, PostgreSQL avtomatik tarzda table_column_idx nomini beradi.
Amaliy misol va unumdorlikni taqqoslash
Keling, amalda indeksning tezlikka ta'sirini ko'ramiz.
1) Jadval yaratish va sinov ma'lumotlarini kiritish
DROP TABLE IF EXISTS products CASCADE;

CREATE TABLE products (
    product_id INT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    product_name VARCHAR(100) NOT NULL,
    price DECIMAL(10, 2) NOT NULL
);

-- 10 000 ta qator generatsiya qilamiz
INSERT INTO products (product_name, price)
SELECT
    'Product ' || i,
    round((random() * 1000 + 10)::numeric, 2)
FROM generate_series(1, 10000) AS i;

-- Alohida bitta mahsulot qo'shamiz
INSERT INTO products (product_name, price)
VALUES ('Sony Xperia 1 VI', 1199.99);
2) Indekssiz qidirish (Seq Scan)
So'rov qanday reja asosida bajarilayotganini ko'rish uchun EXPLAIN ANALYZE buyrug'idan foydalanamiz:
EXPLAIN ANALYZE
SELECT product_name, price
FROM products
WHERE product_name = 'Sony Xperia 1 VI';
Natija:
                                             QUERY PLAN
----------------------------------------------------------------------------------------------------
 Seq Scan on products  (cost=0.00..180.01 rows=1 width=21) (actual time=1.450..1.452 rows=1 loops=1)
   Filter: ((product_name)::text = 'Sony Xperia 1 VI'::text)
   Rows Removed by Filter: 10000
 Planning Time: 0.120 ms
 Execution Time: 1.480 ms
E'tibor bering: Seq Scan on products — PostgreSQL jadvaldagi barcha 10 000 ta qatorni birma-bir tekshirib chiqdi.
3) Indeks yaratish
Endi product_name ustuni bo'yicha indeks yaratamiz:
CREATE INDEX idx_products_name ON products(product_name);
4) Indeks yordamida qidirish (Index Scan)
Xuddi shu so'rovni qayta bajaramiz:
EXPLAIN ANALYZE
SELECT product_name, price
FROM products
WHERE product_name = 'Sony Xperia 1 VI';
Natija:
                                                       QUERY PLAN
------------------------------------------------------------------------------------------------------------------------
 Index Scan using idx_products_name on products  (cost=0.29..8.30 rows=1 width=21) (actual time=0.045..0.046 rows=1 loops=1)
   Index Cond: ((product_name)::text = 'Sony Xperia 1 VI'::text)
 Planning Time: 0.150 ms
 Execution Time: 0.065 ms
Natijaga e'tibor bering:
Index Scan using idx_products_name— endi so'rov indeks orqali bajarildi.- Bajarilish vaqti
1.480 msdan0.065 msgacha qisqardi (20 barobardan ko'proq tezlashdi!).
5) Indeksni o'chirish
Indeksni o'chirish uchun DROP INDEX ishlatiladi:
DROP INDEX idx_products_name;
PostgreSQLdagi indeks turlari
PostgreSQL turli xil ma'lumotlar va vazifalar uchun mo'ljallangan bir nechta indeks turlarini qo'llab-quvvatlaydi:
| Indeks turi | Vazifasi va qo'llanish sohasi |
|---|---|
| B-Tree | Sukut bo'yicha (default) indeks turi. Tenglik (=) va oraliq (<, <=, >, >=) shartlari uchun juda samarali. |
| Hash | Faqatgina oddiy tenglik (=) qidiruvlari uchun optimallashtirilgan. |
| GIN (Generalized Inverted Index) | Murakkab va to'plamli turlar: massivlar (ARRAY), JSONB va to'liq matnli qidiruv (Full-Text Search) uchun. |
| GiST (Generalized Search Tree) | Geometrik ma'lumotlar, oraliqlar (range types) va fazoviy qidiruvlar uchun. |
| SP-GiST (Space-Partitioned GiST) | Balanslashmagan daraxt tuzilmalari, iyerarxik va fazoviy ma'lumotlar uchun. |
| BRIN (Block Range Index) | Tabiiy tartiblangan (masalan, sana bo'yicha o'suvchi) ulkan jadvallar uchun ixcham va tejamkor indeks. |
Xulosa
- PostgreSQL jadvallarni heap fayllarida, 8 KB li bloklarda saqlaydi.
- Indekssiz qidirish to'liq jadvalni skanerlashga (
Seq Scan) olib keladi. - Indekslar so'rovlarni bir necha barobar tezlashtiradi, lekin jadvalga ma'lumot qo'shish va yangilashda qo'shimcha disk va resurs talab qiladi.
EXPLAIN ANALYZEorqali so'rov indeksdan foydalanayotganini tekshirish mumkin.